
Praktičan vodič: pretvaranje kvota u implicirane verovatnoće i procena margine
Razumevanje kvota i kako ih prevesti u verovatnoću
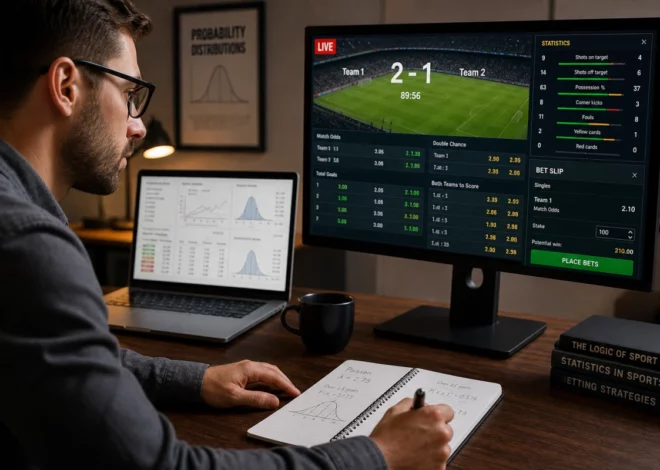
Kvote odražavaju očekivanja tržišta i bukmejkera, ali da biste ih koristili u analizi i statistika pri klađenju, potrebno ih je pretvoriti u implicirane verovatnoće. Najjednostavnija formula za decimalne kvote (najčešće u Evropi) je:
- Implicirana verovatnoća = 1 / decimalna kvota
Primer: za kvotu 2.50, implicirana verovatnoća = 1 / 2.50 = 0.40 (40%). Ovo važi i za pojedinačne ishode (npr. pobeda‑remi‑poraz). Za američke ili fractional kvote prvo ih treba konvertovati u decimalne kvote.
Brze formule za Excel, R i Python
Praktične formule olakšavaju rad sa većim skupovima podataka:
- Excel (decimalne kvote u koloni B): u ćeliji C2 =1/B2; za normalizaciju (bez margine) u D2 =C2/SUM($C$2:$C$4).
- R: odds
- Python (numpy): import numpy as np; odds = np.array([o1,o2,o3]); probs = 1/odds; probs = probs / probs.sum().
Procena bukmejkerske margine (overround) i korekcija verovatnoća
Bukmejkerska margina znači da zbir impliciranih verovatnoća za sve moguće ishode obično prelazi 100 %. Ta razlika predstavlja marginu i treba je ukloniti ako želite uporedivu ili “fer” procenu verovatnoće.
- Skupna implicirana verovatnoća = Σ (1 / kvota_i).
- Margina (overround) = Σ(1/kvota_i) − 1. Izraženo u procentima: 100 × (Σ(1/kvota_i) − 1).
- Normalizovane verovatnoće (bez margine) = (1/kvota_i) / Σ(1/kvota_j).
Primer: za tri ishoda sa kvotama 2.50, 3.20 i 2.80 zbir impliciranih verovatnoća može biti npr. 1.08 → margina 8 %. Normalizacijom se dobija skala koja sumira na 1 (100 %).
Praktična ograničenja pri proceni margine
- Margina se može razlikovati između ishoda i tržišta: bukmejker može raspodeliti marginu neravnomerno (npr. više na remi). Jednostavna normalizacija podrazumeva proporcionalnu distribuciju, što nije uvek tačno.
- Kvote su podložne promenama i za promocije; kratkoročno kretanje može izmeniti implicirane verovatnoće.
- Arbitraža, limitiranje korisnika i tehničke greške mogu dovesti do kvota koje ne odražavaju istinski rizik.
Ove osnove su neophodne pre nego što se pređe na procenu kako dobro kvote odražavaju stvarne verovatnoće (kalibracija) i na statističke testove koji mere tu kalibraciju. U narednom delu biće objašnjeni alati za testiranje kalibracije — reliability diagrams, Brier score i chi‑square test — kao i koraci za konstrukciju intervala poverenja pomoću bootstrap metoda, sa primerima u Excel‑u, R‑u i Python‑u, pri čemu će se detaljno razmotriti i ograničenja svake metode u kontekstu statistika pri klađenju.
Testiranje kalibracije: reliability diagrami i Brier score
Reliability diagram (graf kalibracije) pokazuje kako se prosečne empirijske frekvencije događaja slažu sa impliciranim verovatnoćama bukmejkera. Brier score kvantifikuje prosečnu kvadratnu grešku predviđanja i daje jedinstvenu meru kalibracije i oštrine predikcija.
Koraci za izradu reliability diagram-a:
1. Podelite predviđene verovatnoće u k binova (npr. 10 binova po 0.1).
2. Za svaki bin izračunajte: a) srednju predviđenu verovatnoću (p̄_bin) b) empirijsku frekvenciju događaja (obs_bin = broj događaja / broj opservacija u binu).
3. Nacrtajte obs_bin protiv p̄_bin; linija p̄_bin = obs_bin (45°) predstavlja savršnu kalibraciju. Dodajte barove poverenja po binu (npr. binomski 95% CI).
Excel:
– Pretpostavimo da su predviđene verovatnoće u koloni B i binarne ishodi (0/1) u koloni C.
– Napravite listu binova (npr. D2:D11 za granice 0–0.1, 0.1–0.2,…).
– Broj opservacija u binu i sumu uspeha koristite COUNTIFS i SUMIFS:
– Broj: =COUNTIFS(B:B,”>=”&D2,B:B,”=”&D2,B:B,”=”&D2,B:B,”% group_by(bin) %>% summarise(p_bar=mean(pred), obs_freq=mean(y), n=n())
– Plot: ggplot(agg, aes(x=p_bar,y=obs_freq)) + geom_point() + geom_abline(slope=1,intercept=0)
– Brier score: mean((df$pred – df$y)^2)
Python:
– Koristite pandas i matplotlib:
– df[‘bin’] = pd.cut(df[‘pred’], bins=np.linspace(0,1,11))
– agg = df.groupby(‘bin’).agg(p_bar=(‘pred’,’mean’), obs_freq=(‘y’,’mean’), n=(‘y’,’size’)).reset_index()
– plt.scatter(agg.p_bar, agg.obs_freq); plt.plot([0,1],[0,1],’k–‘)
– Brier score: np.mean((df[‘pred’].values – df[‘y’].values)**2)
Napomena za višeklasne ishode (npr. 1X2): crtajte reliability diagram po ishodu (one‑vs‑rest) ili koristite multiklasični Brier (suma kvadratnih razlika po klasama).
Chi‑square test za kalibraciju i konstrukcija bootstrap intervala poverenja
Chi‑square test upoređuje posmatrane i očekivane brojeve događaja po binovima. Statistika: Χ² = Σ (O_i − E_i)^2 / E_i, gde su E_i = n_i * p̄_i (prosečna predviđena verovatnoća u binu). Stepeni slobode obično su broj binova − 1 (ili − broj parametara ako su parametri procenjivani). Ograničenja: očekivane vrednosti u binovima trebaju biti dovoljno velike (preporuka ≥5).
Excel:
– Izračunajte O_i i E_i kao u prethodnom odeljku.
– Χ² ćelija = SUMXMY2(range_O, range_E) / range_E equivalent (ili ručno sumirajte (O−E)^2/E po binovima).
– P‑vrednost: =CHISQ.DIST.RT(χ², df)
R:
– chisq Ograničenja metoda i praktične preporuke
– Binning utiče na rezultate: manji broj binova povećava broj u binu (manja varijansa) ali gubi detalje; više binova može ostaviti prazne/retke binove i narušiti chi‑kvadrat uslove. Testirajte različite postavke (npr. 5, 10, quantile binning).
– Nezavisnost opservacija: bootstrap i chi‑kvadrat pretpostavljaju da su opservacije nezavisne. Kod serija utakmica ili favorita sa vremenskom korelacijom ta pretpostavka može biti narušena.
– Selektivni uzorci i preživljavanje tržišta: podaci skupljeni samo iz aktivnih/vidljivih tržišta (ili promocija) mogu imati pristrasnosti.
– Višeklasne situacije: za 1X2 tržišta radije procenjujte po ishodu i budite oprezni sa korelacijama između predviđanja klasa.
– Bootstrap je računarski intenzivan; u Excelu je ograničen i sklon greškama pri velikim B. Koristite R/Python za ozbiljnije analize.
U narednom delu ćemo detaljnije prikazati primere koda i gotove Excel šablone za tipične 1X2 skupove podataka, kao i praktične korake za interpretaciju rezultata i upotrebu intervala poverenja pri donošenju odluka o klađenju.
Završne smernice za primenu i dalji rad
Kratko i jasno: pristupajte kvotama i njihovoj analizi kao radu sa verovatnoćama — uz oprez, dokumentaciju i stalnu validaciju. Korišćenje reliability diagram‑a, Brier score‑a, chi‑square testa i bootstrap intervala poverenja daje moćne alate, ali zahteva pažnju prema pretpostavkama i kvalitetu podataka. Slede praktične smernice za svakodnevnu primenu i dalje unapređenje analiza.
Preporučene prakse
- Automatizujte obradu podataka i verzionisanje skripti (R/Python) radi reproduktivnosti i lakog ponovnog testiranja.
- Uvek proverite nezavisnost i reprezentativnost uzorka pre nego što tumačite intervale poverenja ili p‑vrednosti.
- Koristite više postavki binovanja (npr. jednakih širina i kvantilno binovanje) da testirate stabilnost rezultata.
- Za bootstrap birajte dovoljno veliki broj ponavljanja (npr. ≥2000) i resampliciranje indeksa umesto odvojenih kolona kako biste očuvali parove predikcija i ishoda.
- Preferirajte intervale poverenja i veličine efekata umesto oslonca samo na statističku značajnost; to daje praktičniju informaciju za odluke.
Ograničenja i odgovorno korišćenje
- Ne tumačite pojedinačne statističke testove kao konačan dokaz; kombinujući indikatore (grafikoni, Brier, CI) dobijate robustniju sliku.
- Budite oprezni kod malih ili selektivnih podataka — bootstrap i chi‑kvadrat mogu dati zavaravajuće rezultate ako su pretpostavke narušene.
- Ne ignorišite tržišne faktore (promocije, ograničenja računa, brzo menjanje kvota) koji utiču na interpretaciju kalibracije u realnom vremenu.
- Pri donošenju finansijskih odluka uzmite u obzir i upravljanje rizikom — statistička prednost ne garantuje profit bez pravilnog stake menadžmenta.
Dalji koraci za analitičare
- Implementirajte end‑to‑end pipeline: čišćenje podataka → konverzija kvota → korekcija margine → kalibracija → bootstrap CI → izveštavanje.
- Eksperimentišite sa modelima koji direktno predviđaju verovatnoće i uporedite njihove kalibracione karakteristike sa impliciranim verovatnoćama bukmejkera.
- Redovno revalodirajte metode na novim podacima i vodite evidenciju promena u tržišnim uslovima koje mogu uticati na rezultate.
- Delite kod i dokumentaciju unutar tima kako biste smanjili rizik od grešaka i povećali transparentnost analiza.
Primena ovih smernica pomoći će vam da rezultati budu robustniji, transparentniji i korisniji za praktične odluke — uz jasno razumevanje kada statistika ukazuje na pouzdanu informaciju, a kada je potrebna dodatna provera ili ograničenje u interpretaciji.
Praktičan primer: analiza realnog skupa podataka
Da bismo ilustrovali celokupan postupak na jednom mestu, razmotrimo hipotetički skup podataka sa 10.000 utakmica 1X2 tržišta prikupljenih iz više bukmejkerskih izvora. Osnovni koraci analize bi bili:
- Učitavanje i čišćenje podataka: ukloniti duplikate, sinkronizovati vremenske oznake, osigurati da su kvote i ishodi u odgovarajućim formatima.
- Konverzija kvota u implicirane verovatnoće i korekcija margine koristeći normalizaciju kako je opisano ranije.
- Podjela podataka na trening i test set (npr. 70/30 ili hronološki: prvi period kao trening, kasniji kao test) da se izbegne curenje informacija kroz vreme.
- Izrada reliability diagram-a po ishodu: kvantilno binovanje (npr. 10 binova po kvantilima) često daje ravnomerniju raspodelu u binovima i bolje zadovoljava uslove za chi‑kvadrat.
- Proračun Brier score-a ukupno i po ishodu, kao i bootstrap intervala poverenja (npr. B=5000) da se procene nesigurnosti u oceni kalibracije.
- Chi‑square test uz proveru da li su očekivane vrednosti u svim binovima dovoljne (≥5) i, ako nisu, redukcija broja binova ili spajanje susednih binova.
Nakon sprovođenja ovih koraka dobijaju se kvantitativne metrike (Brier, Χ² i p‑vrednosti, bootstrap CI) i vizuelni uvidi (grafovi kalibracije). Na osnovu rezultata se donose odluke: da li su implicirane verovatnoće dobro kalibrisane, gde postoji sistematska greška (npr. precenjivanje favorita), i da li su potrebne korekcije ili razvoj sopstvenog modela verovatnoće.
Interpretacija rezultata — primeri
- Ako reliability diagram pokazuje da su predviđene verovatnoće konzistentno iznad empirijskih (tačke ispod linije p̄=obs), to implicira da bukmejker precenjuje verovatnoće događaja; moguće su prilike za vrednosno klađenje ako imate nezavisne procene koje su realističnije.
- Ako je Brier score nizak i CI uzak, predviđanja su precizna i stabilna; široki CI ukazuje na veliku varijabilnost i manju poverljivost procene.
- Niska p‑vrednost u chi‑kvadrat testu signalizira odstupanje između očekivanog i opaženog — to može biti posledica loše kalibracije ili nepravilnog binovanja; vizuelna provera i bootstrap pomažu razjasniti situaciju.
Napredne tehnike za poboljšanje kalibracije
Osim osnovne normalizacije i binovanja, postoje metode koje mogu pomoći da predikcije (bilo od bukmejkera ili modela) budu bolje kalibrisane:
- Plattova skalacija: logistička regresija koja transformiše ne-kalibrisane verovatnoće u bolje kalibrisane procene; često koristite kada imate kontinuirani “score” prediktora.
- Izotonijska regresija: nemetrička metoda koja očuva poredak verovatnoća i može ispraviti sistematske nekonzistentnosti bez pretpostavke o obliku transformacije.
- Bayesov pristup: modelovanje neizvesnosti u verovatnoćama pomoću hijerarhijskih modela ili regularizovanih procena (npr. korišćenje beta‑distribucija za binomni slučaj) omogućava bolju procenu nesigurnosti i robustnost kod malih uzoraka.
- Kalibracioni ensemble: kombinovanje više metoda kalibracije (npr. Platt + isotonic) sa modelom za odabir prema validacionim metrikama često daje najbolju praktičnu izvedbu.
Važno je testirati svaku od ovih tehnika na odvojenom validacionom skupu kako ne biste “prekalibrisali” model na specifičnosti trening skupa i izgubili sposobnost generalizacije.
Automatizacija, monitoring i produžena evaluacija
U produkcijskim ili poluprofesionalnim okruženjima preporučljivo je uvesti automatizovane pipeleine za stalni monitoring kalibracije kvota i modela. Ključni elementi takvog sistema su:
- Periodični procesi (npr. dnevni/weekly job) koji povlače nove kvote i ishode, konvertuju kvote i ažuriraju metrike kalibracije.
- Alerting: automatske notifikacije kada Brier score, chi‑kvadrat p‑vrednost ili margin prelaze unapred definisane pragove.
- Versioning metapodataka: beleženje izvora kvota, verzija skripti i datuma kako biste mogli rekonstruisati promene i analizirati uticaj tržišnih promena ili bugs-a.
- Vizuelni dashboard: grafovi kalibracije kroz vreme, kretanje margine, histograme razlika između bukmejkerskih i vaših procena.
Ovo omogućava rano uočavanje promene u ponašanju tržišta (npr. agresivno snizavanje kvota na određene događaje) i brzu reakciju u analizi ili strategiji klađenja.
Check‑lista pre pokretanja statističkih testova
- Da li su opservacije nezavisne ili postoji temporalna korelacija? Ako postoji, razmotrite blok‑bootstrap ili modeliranje zavisnosti.
- Da li su očekivane vrednosti po binovima dovoljne za upotrebu chi‑kvadrat testa? Ako nisu, smanjite broj binova ili koristite Fisher‑ov test/Monte Carlo pristup.
- Da li su vaši parovi predikcija i ishoda usklađeni prilikom bootstrap resampliranja (resamplicirajte indekse, ne odvojeno pred i y)?
- Da li postoje sistematske greške u skupljanju podataka (npr. kasna ažuriranja kvota, ručne korekcije)? Dokumentujte i korigujte pre analize.
- Imate li dovoljan broj opservacija po ishodu da opravdate višeklasne procene? Ako ne, fokusirajte se na one‑vs‑rest evaluaciju.
Korisni resursi, alati i literatura za dalje učenje
- Biblioteke: scikit‑learn (calibration_curve, isotonic regression), statsmodels, boot package u R, tidyverse za manipulaciju podacima.
- Vizualizacija: ggplot2 (R), matplotlib/seaborn (Python), Power BI ili Tableau za produkcione dashboarde.
- Članci i knjige: tekstovi o kalibraciji klasifikatora, radovi o Brier score i proper scoring rules, literature o tržišnim kvotama i arbitrži.
- Open data: javno dostupne arhive rezultata i kvota (gdje je legalno koristiti) su korisne za backtesting i repliciranje eksperimenata.
Zaključno, kombinacija dobro strukturisanog procesa, adekvatnih statističkih metoda i stalnog monitoringa daje kredibilne i praktično upotrebljive rezultate. Nastavite da eksperimentišete sa različitim pristupima kalibraciji, dokumentujte nalaze i uporedite ih s tržišnim promenama kako biste održali relevantnost i tačnost procena kroz vreme.